
Data Skew: problema de desequilíbrio na distribuição dos dados
Índice
- Técnicas na Engenharia de Dados
- Técnicas na Ciência de Dados
- Exemplo hipotético – Engenharia de Dados com Spark
- Exemplo hipotético – Fraude em Cartão de Crédito
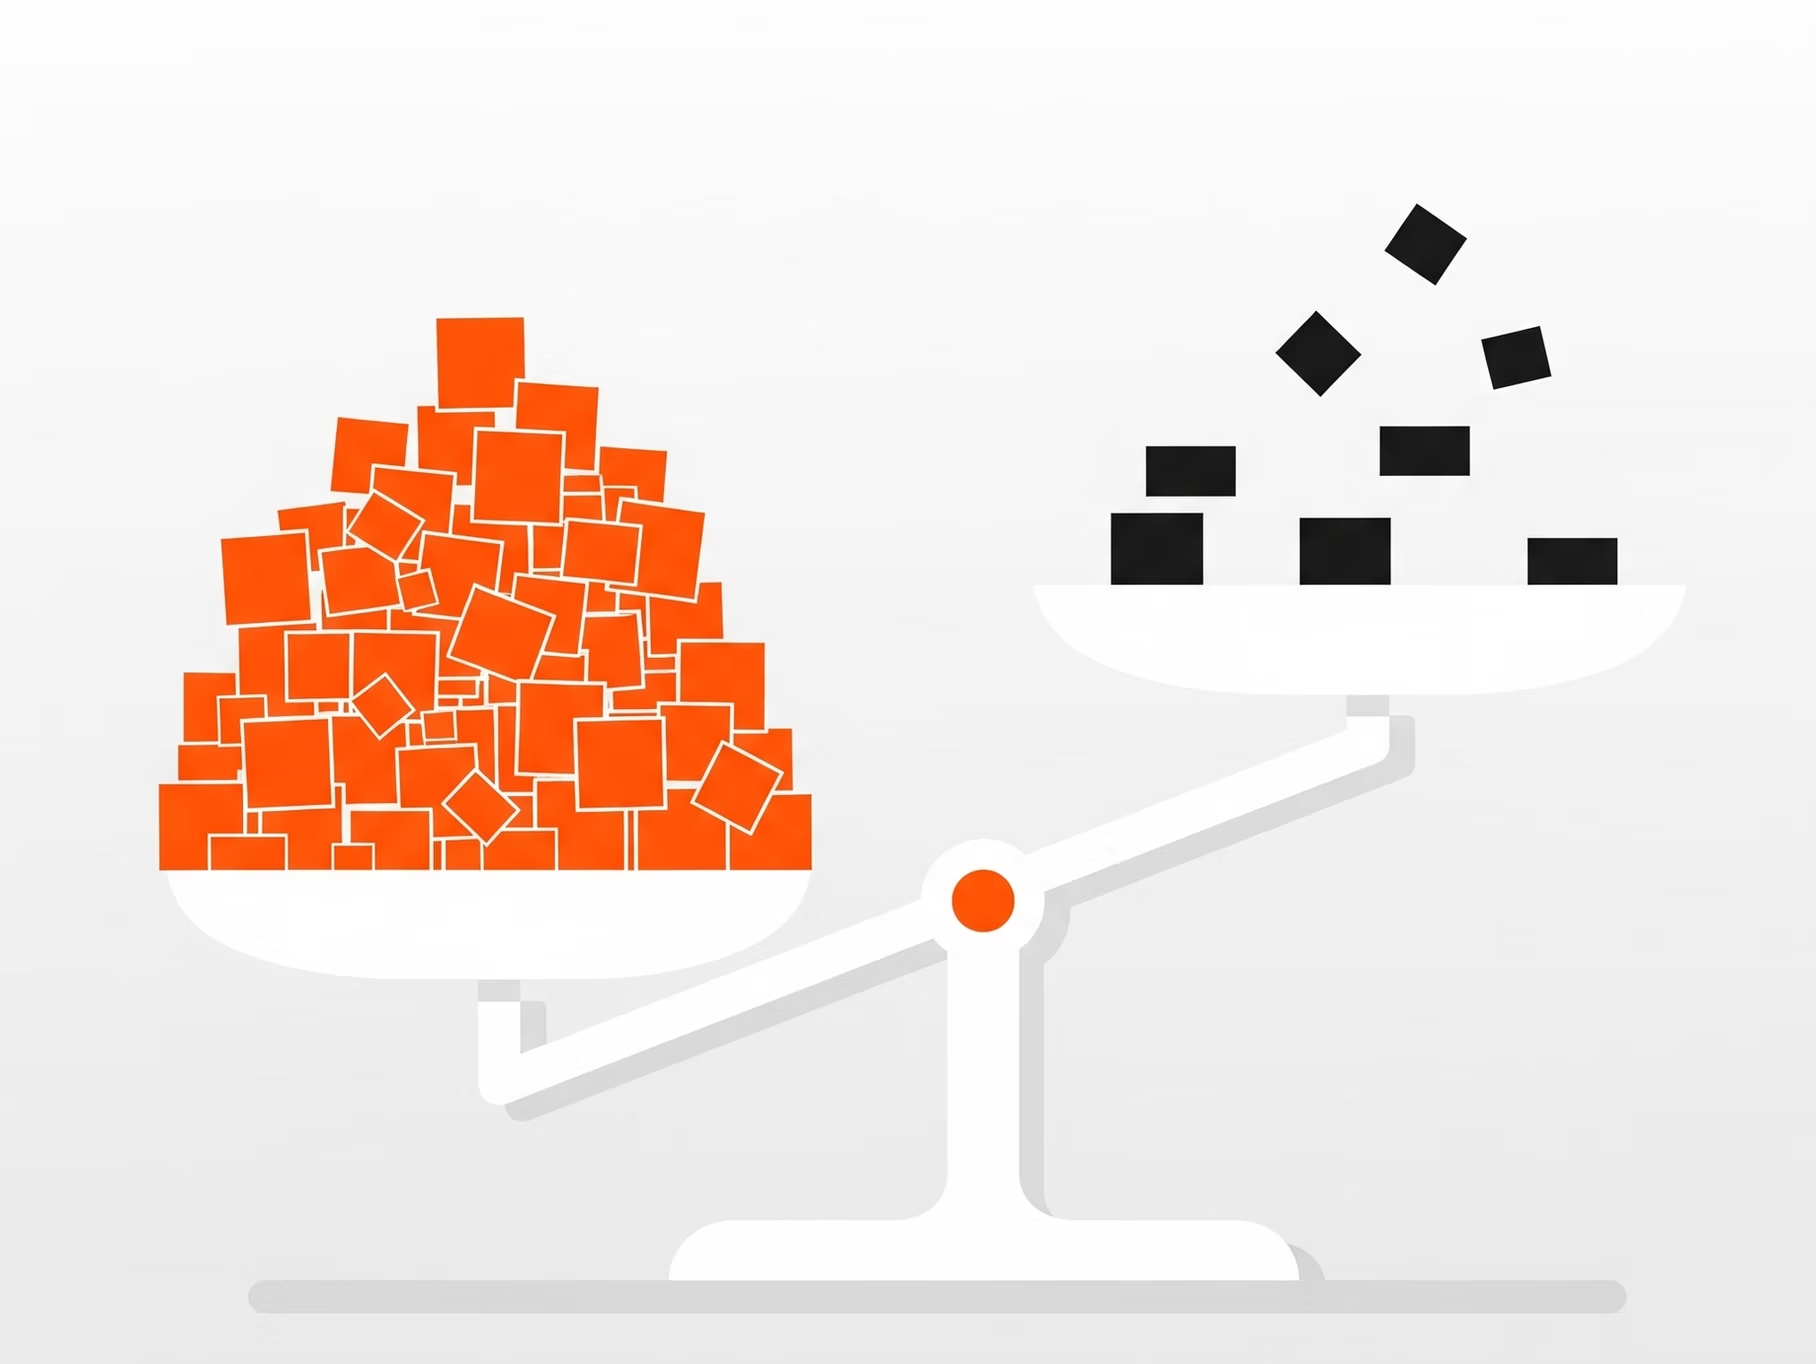 Data Skew é um problema de desequilíbrio na distribuição dos dados mas o termo tem significados distintos dependendo do contexto:
Engenharia de Dados: Dados não estão distribuídos de forma uniforme entre partições ou nós em motores distribuídos (Spark, Flink, etc.). Isso gera gargalos, lentidão, falhas de tarefas e uso ineficiente de recursos.
Ciência de Dados: Refere-se ao viés estatístico das variáveis: classes desbalanceadas (fraude, eventos raros), presença de outliers ou amostras enviesadas. Isso pode distorcer padrões e prejudicar a generalização dos modelos.
Técnicas na Engenharia de Dados
-
Salting Keys → quebra concentração de chaves dominantes.
-
Bucketing → pré-agrupamento fixo, reduz shuffle em joins recorrentes.
-
Repartitioning → redistribui dados em partições extras (simples, mas gera overhead).
-
Algoritmos customizados → tratar manualmente cargas pesadas (heavy hitters).
Técnicas na Ciência de Dados
-
Oversampling/Undersampling → equilibrar classes.
-
Modelos especializados → One-Class SVM, Anomaly Detection para eventos raros.
-
Feature engineering + métricas adequadas → usar F1-score, AUC em vez de só acurácia.
-
Quando não agir → em alguns casos o desequilíbrio é natural e deve apenas ser considerado na avaliação.
Trade-offs Importantes
-
Engenharia de dados → mais partições = mais tarefas, rede e disco.
-
Ciência de dados → balanceamento artificial pode gerar overfitting ou viés.
A escolha da técnica depende do objetivo: no mundo distribuído, priorizar eficiência e throughput. Na modelagem, priorizar generalização e evitar viés.
Exemplo hipotético – Engenharia de Dados com Spark
Considere um job do Apache Spark que relaciona logs de acesso com uma tabela de usuários. Uma parcela relevante dos eventos anônimos utiliza user_id = null, concentrando registros em poucas partições e fazendo algumas tarefas demorarem muito mais que as demais.
Eu começaria confirmando o desequilíbrio pelas métricas de execução:
- quantidade de registros por partição;
- duração das tarefas mais lentas;
- volume de dados transferidos durante o shuffle;
- uso de memória e disco pelos executores;
- falhas ou novas tentativas associadas às partições maiores.
A estratégia depende do significado dos registros sem usuário. Se eles não precisam participar do relacionamento, podem ser processados separadamente. Se precisam permanecer no cálculo, técnicas como salting ou outra forma de particionamento podem ser avaliadas.
A comparação deve registrar a configuração usada, o volume processado e o tempo de execução antes e depois. Sem essas medições, o exemplo demonstra uma possibilidade de diagnóstico, mas não sustenta um percentual de melhoria.
Exemplo hipotético – Fraude em Cartão de Crédito
Considere um conjunto de transações no qual as fraudes representam uma pequena parte dos registros. Nesse cenário, um modelo que classifica todas as transações como legítimas pode apresentar acurácia elevada e, ainda assim, não detectar nenhuma fraude.
Antes de escolher uma técnica de balanceamento, eu começaria por três medições:
- prevalência de fraudes no conjunto de dados;
- precisão e recall da classe de fraude;
- quantidade de falsos positivos que a operação consegue revisar.
Técnicas como ponderação de classes, reamostragem ou detecção de anomalias podem ser comparadas com o modelo inicial. A escolha deve considerar não apenas o recall, mas também o custo operacional dos falsos positivos.
O resultado só deve ser apresentado depois da medição, registrando pelo menos:
- dataset e período avaliados;
- divisão entre treino e teste;
- precisão e recall antes e depois;
- falsos positivos por volume de transações;
- limitações conhecidas do experimento.
Sem essas medições, o exemplo demonstra o processo de avaliação, mas não sustenta uma conclusão sobre o desempenho que será obtido.