
Layered Architecture: responsabilidades e limites
Índice
- Camada não é tier
- Variações de dependência
- Uma implementação possível em FastAPI
- Fluxo do caso de uso
- Comparação com organização por slices
- Benefícios possíveis
- Custos e modos de falha
- Organização não determina implantação
- Quando considerar a abordagem
- Referências
Arquitetura em camadas organiza o software em grupos de responsabilidades e define quais dependências são permitidas entre esses grupos. A intenção é separar decisões que mudam por razões diferentes, como contratos HTTP, coordenação de casos de uso e acesso ao banco.
Controller → Service → Repository é uma implementação comum em APIs, mas não é a definição completa do padrão. Outras aplicações podem usar camadas de apresentação, aplicação, domínio e infraestrutura, além de regras de dependência diferentes.
O ponto central é lógico: uma camada oferece serviços à camada acima e protege detalhes da camada abaixo. A quantidade de processos, deploys, servidores ou bancos pertence a outra decisão arquitetural.
Camada não é tier
Os termos são próximos, mas respondem a perguntas diferentes:
| Elemento | Pergunta que responde | Exemplo |
|---|---|---|
| Camada lógica | Qual responsabilidade este código possui? | Apresentação, aplicação, domínio, persistência |
| Módulo ou pacote | Como o código é empacotado e seus acessos são controlados? | Pacote Python, módulo de domínio |
| Processo | O que executa na mesma memória e ciclo de vida? | Processo da API, Worker |
| Unidade de deploy | O que é versionado e publicado junto? | Imagem da API, função, serviço |
| Data store | Onde o estado é persistido e quem o controla? | PostgreSQL, Redis, object storage |
Uma aplicação pode manter todas as camadas no mesmo processo e deploy. Também pode colocar camadas em tiers físicos diferentes. Nenhuma dessas topologias é consequência automática da organização do código.
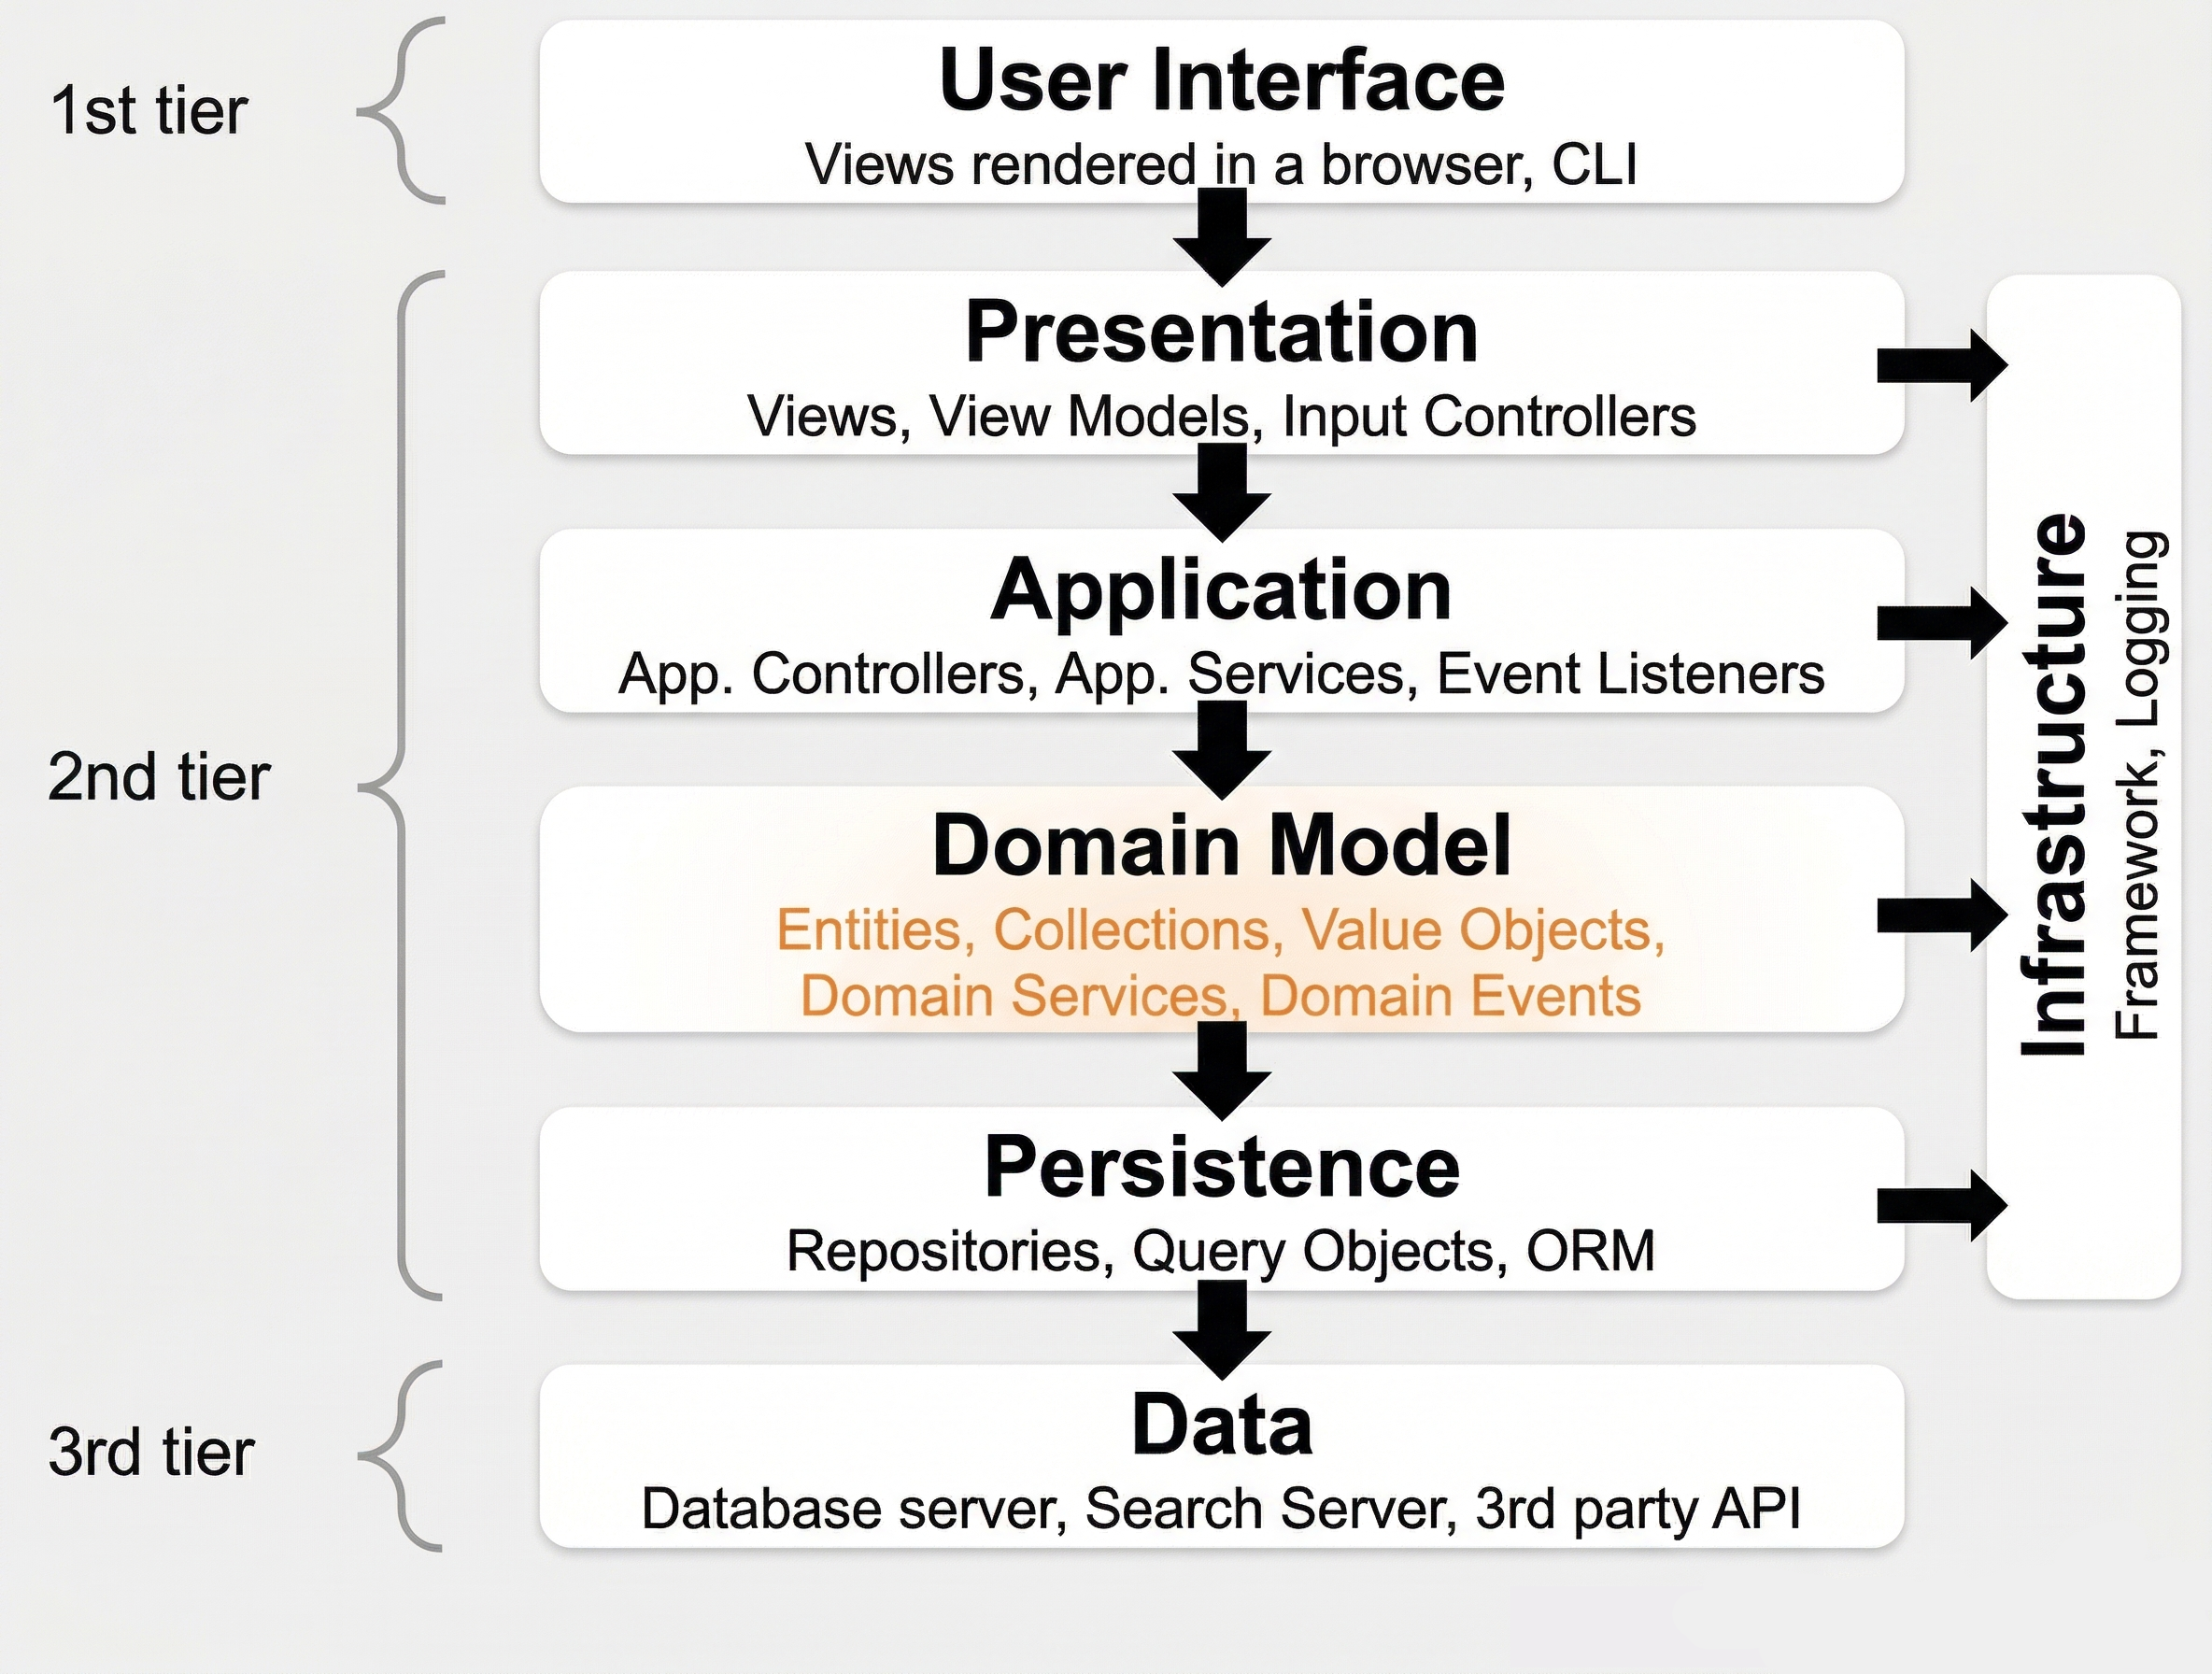
O diagrama mostra uma possibilidade: apresentação em um tier, várias camadas de aplicação no mesmo tier intermediário e dados em outro tier. Ele não estabelece uma quantidade obrigatória de camadas ou servidores.
Variações de dependência
Uma arquitetura em camadas precisa declarar sua regra de dependência.
- Camadas fechadas: uma camada chama apenas a camada imediatamente abaixo. A regra restringe dependências, mas pode criar componentes que apenas repassam chamadas.
- Camadas abertas: uma camada pode acessar camadas inferiores sem passar por todas as intermediárias. O caminho é menor, mas aumenta o número de dependências permitidas.
- Dependências invertidas: interfaces podem ser definidas em uma camada interna e implementadas pela infraestrutura. Essa variação altera a direção das dependências de código sem eliminar as responsabilidades lógicas.
Não existe uma regra única adequada a todos os sistemas. A documentação deve informar qual variação foi escolhida e quais acessos são proibidos.
Uma implementação possível em FastAPI
O exemplo a seguir usa Python 3.11, FastAPI, Pydantic 2 e SQLAlchemy 2. Ele representa uma aplicação em um único processo apenas para manter o cenário delimitado. A mesma organização lógica poderia ser empacotada ou implantada de outra forma.
O banco SQLite também é uma escolha didática. O schema deve ser criado por migrações; o exemplo não usa create_all() durante a inicialização da aplicação.
Estrutura
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
projeto/
├── app/
│   ├── __init__.py
│   ├── main.py
│   ├── database.py
│   ├── dependencies.py
│   ├── controllers/
│   │   ├── __init__.py
│   │   └── product_controller.py
│   ├── services/
│   │   ├── __init__.py
│   │   └── product_service.py
│   ├── repositories/
│   │   ├── __init__.py
│   │   └── product_repository.py
│   ├── models/
│   │   ├── __init__.py
│   │   └── product.py
│   └── schemas/
│       ├── __init__.py
│       └── product_schema.py
└── alembic/
Essa estrutura separa o código por responsabilidade técnica. Ela não impede que o projeto também crie módulos de negócio acima dessas pastas quando o domínio crescer.
Sessão do banco
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
# app/database.py
from collections.abc import Generator

from sqlalchemy import create_engine
from sqlalchemy.orm import DeclarativeBase, Session


class Base(DeclarativeBase):
    pass


engine = create_engine(
    "sqlite:///catalog.db",
    connect_args={"check_same_thread": False},
)


def get_session() -> Generator[Session, None, None]:
    with Session(engine) as session:
        yield session
Em produção, a URL do banco e as opções do engine deveriam vir da configuração do ambiente. A dependência com yield delimita o ciclo de vida da sessão por requisição, mas a transação continua sob responsabilidade da camada de aplicação.
Modelo de persistência
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
# app/models/product.py
from sqlalchemy import String
from sqlalchemy.orm import Mapped, mapped_column

from app.database import Base


class Product(Base):
    __tablename__ = "product"

    id: Mapped[int] = mapped_column(primary_key=True)
    name: Mapped[str] = mapped_column(
        String(120),
        unique=True,
        nullable=False,
    )
Contratos HTTP
1
2
3
4
5
6
7
8
9
10
11
12
13
# app/schemas/product_schema.py
from pydantic import BaseModel, ConfigDict, Field


class CreateProductRequest(BaseModel):
    name: str = Field(min_length=1, max_length=120)


class ProductResponse(BaseModel):
    model_config = ConfigDict(from_attributes=True)

    id: int
    name: str
ConfigDict(from_attributes=True) explicita o uso do Pydantic 2 para serializar o objeto SQLAlchemy. O contrato HTTP não precisa ser o mesmo objeto usado pela persistência.
Repository
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
# app/repositories/product_repository.py
from sqlalchemy.orm import Session

from app.models.product import Product


class ProductRepository:
    def __init__(self, session: Session) -> None:
        self._session = session

    def add(self, product: Product) -> Product:
        self._session.add(product)
        self._session.flush()
        return product

    def get(self, product_id: int) -> Product | None:
        return self._session.get(Product, product_id)
O repository encapsula as operações de persistência usadas pelo exemplo. Ele executa flush(), mas não confirma a transação; commit() e rollback() permanecem na camada que coordena o caso de uso.
Service e fronteira transacional
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
# app/services/product_service.py
from sqlalchemy.exc import IntegrityError
from sqlalchemy.orm import Session

from app.models.product import Product
from app.repositories.product_repository import ProductRepository


class ProductAlreadyExistsError(Exception):
    pass


class ProductService:
    def __init__(
        self,
        repository: ProductRepository,
        session: Session,
    ) -> None:
        self._repository = repository
        self._session = session

    def create(self, name: str) -> Product:
        product = Product(name=name)
        try:
            self._repository.add(product)
            self._session.commit()
            self._session.refresh(product)
        except IntegrityError as exc:
            self._session.rollback()
            raise ProductAlreadyExistsError(name) from exc
        except Exception:
            self._session.rollback()
            raise
        return product
O service coordena a transação porque conhece o limite do caso de uso. A violação de unicidade do banco é convertida em um erro da aplicação; a camada HTTP decidirá como expor esse erro.
Composição das dependências
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
# app/dependencies.py
from typing import Annotated

from fastapi import Depends
from sqlalchemy.orm import Session

from app.database import get_session
from app.repositories.product_repository import ProductRepository
from app.services.product_service import ProductService


SessionDependency = Annotated[Session, Depends(get_session)]


def get_product_service(
    session: SessionDependency,
) -> ProductService:
    repository = ProductRepository(session)
    return ProductService(repository, session)


ProductServiceDependency = Annotated[
    ProductService,
    Depends(get_product_service),
]
A composição conhece as classes concretas. Isso evita que o controller construa repository e service manualmente e mantém explícito onde as dependências são conectadas.
Controller
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
# app/controllers/product_controller.py
from fastapi import APIRouter, HTTPException, status

from app.dependencies import ProductServiceDependency
from app.schemas.product_schema import (
    CreateProductRequest,
    ProductResponse,
)
from app.services.product_service import ProductAlreadyExistsError


router = APIRouter(prefix="/products", tags=["products"])


@router.post(
    "",
    response_model=ProductResponse,
    status_code=status.HTTP_201_CREATED,
)
def create_product(
    request: CreateProductRequest,
    service: ProductServiceDependency,
):
    try:
        return service.create(name=request.name)
    except ProductAlreadyExistsError as exc:
        raise HTTPException(
            status_code=status.HTTP_409_CONFLICT,
            detail="Product name already exists",
        ) from exc
O controller traduz HTTP para uma chamada de aplicação e converte um erro conhecido em 409 Conflict. Erros inesperados continuam propagando para o tratamento e a observabilidade configurados na aplicação.
Aplicação
1
2
3
4
5
6
7
8
# app/main.py
from fastapi import FastAPI

from app.controllers.product_controller import router as product_router


app = FastAPI(title="Product Catalog")
app.include_router(product_router)
O exemplo não inclui autenticação, migração Alembic, logging ou tratamento global de erros. Esses elementos dependem dos requisitos da aplicação e não são benefícios automáticos da arquitetura em camadas.
Fluxo do caso de uso
No exemplo de criação:
- o controller valida o contrato HTTP e chama o service;
- o service coordena o caso de uso e a transação;
- o repository executa operações de persistência;
- o banco aplica a restrição de unicidade;
- erros conhecidos retornam pelas camadas e são traduzidos na fronteira HTTP.
Esse fluxo é uma política do exemplo. Outra aplicação em camadas poderia permitir que a apresentação chamasse diretamente uma query de leitura, usar uma Unit of Work ou colocar regras em um modelo de domínio.
Comparação com organização por slices
Arquitetura em camadas e Vertical Slice escolhem eixos diferentes de organização. A tabela descreve tendências, não níveis universais de qualidade.
| Critério | Organização por camadas | Organização por slices |
|---|---|---|
| Unidade principal | Responsabilidade técnica | Caso de uso ou requisição |
| Localização de uma mudança | Pode atravessar controller, service e repository | Tende a permanecer próxima da operação |
| Compartilhamento | Frequentemente centralizado por camada | Extraído quando slices precisam compartilhar |
| Consistência estrutural | Convenções comuns por tipo técnico | Cada slice pode adotar estrutura proporcional |
| Risco recorrente | Camadas de repasse e mudanças transversais | Duplicação e divergência entre slices |
| Testes | Por responsabilidade e integração entre camadas | Por comportamento e integrações da slice |
Uma aplicação em camadas pode ter módulos de negócio coesos. Uma aplicação por slices também pode acumular dependências globais. A estrutura de diretórios não determina sozinha acoplamento, qualidade ou facilidade de teste.
Benefícios possíveis
Quando responsabilidades e regras de dependência estão claras, camadas podem:
- concentrar decisões técnicas semelhantes;
- limitar o acesso direto da apresentação à persistência;
- oferecer pontos conhecidos para políticas de transação e integração;
- facilitar a substituição de um detalhe quando o contrato da camada permanece estável;
- ajudar equipes familiarizadas com a mesma convenção a localizar código.
Esses resultados dependem de limites aplicados no código e nos testes. Criar uma pasta chamada services não demonstra separação de responsabilidades.
Custos e modos de falha
- Camadas de repasse: classes existem apenas para encaminhar chamadas sem proteger uma decisão.
- Mudanças transversais: um caso de uso exige alterações em várias pastas técnicas.
- Abstrações prematuras: repositories e interfaces são criados sem uma necessidade de substituição ou isolamento.
- Service amplo: regras de assuntos diferentes se acumulam em uma classe central.
- Modelo anêmico: regras que pertencem ao domínio podem ficar espalhadas em services procedurais.
- Dependências ocultas: imports ou acesso direto ao banco contornam a política declarada.
- Transação indefinida: controller, service e repository tentam confirmar ou reverter a mesma operação.
Esses problemas não são inevitáveis. Eles são sinais para revisar responsabilidades, módulos e regras de dependência.
Organização não determina implantação
Arquitetura em camadas pode existir em diferentes topologias:
- um processo e um deploy: todas as camadas executam na mesma aplicação;
- monólito modular: módulos de negócio possuem camadas internas e são publicados juntos;
- tiers separados: apresentação, aplicação ou dados executam em unidades físicas diferentes;
- microservices: cada serviço pode usar camadas internamente;
- processamento assíncrono: API e Worker podem compartilhar algumas camadas ou possuir implementações próprias.
Separar layers em tiers acrescenta rede, autenticação entre processos, serialização, observabilidade e modos de falha. Manter tudo junto reduz esse custo, mas publica e dimensiona o conjunto como uma unidade. A escolha deve responder a requisitos de escala, disponibilidade, segurança, ownership e ciclo de mudança.
Da mesma forma, camadas não exigem banco centralizado. Um sistema pode ter um data store compartilhado, bancos por serviço ou fontes externas. Ownership e consistência dos dados precisam ser decididos independentemente da estrutura de pacotes.
Quando considerar a abordagem
Arquitetura em camadas pode ser proporcional quando:
- responsabilidades técnicas possuem contratos compreensíveis;
- várias operações reutilizam políticas de aplicação ou persistência;
- a equipe precisa de uma convenção previsível para uma aplicação existente;
- regras de dependência podem ser verificadas por revisão, testes ou ferramentas;
- mudanças transversais permanecem pequenas o suficiente para o contexto.
Outra organização merece avaliação quando a maior parte das mudanças atravessa todas as camadas, quando services e repositories apenas repassam chamadas ou quando módulos de negócio precisam de limites mais explícitos.
O próximo passo não precisa ser distribuir o sistema. Antes disso, é possível reorganizar módulos, aproximar casos de uso, remover abstrações sem função ou combinar camadas com slices dentro de cada domínio.